Karine Sales
Jornalista e criadora de conteúdo digital, atua há mais de 8 anos desenvolvendo estratégias e textos otimizados para blogs, sites e redes sociais.


Karine Sales

Atualizado em 22/10/2026

4 min de leitura

O Google muda mais rápido do que você consegue acompanhar? Não se preocupe, isso é comum pra muita gente.
Se inscreva na nossa Newsletter e fique por dentro das novidades de SEO.
Inscreva-se
O robots.txt pode impedir que um crawler de IA acesse seu site, mas não garante que a IA deixe de usar conteúdo que já foi rastreado para treinar modelos. Isso acontece porque o arquivo controla o acesso ao rastreamento, e não o uso posterior dos dados coletados.
O robots.txt é um arquivo de texto utilizado pelos sites para instruir os robôs de busca sobre quais partes do site devem ser rastreadas e indexadas, e quais devem ser evitadas.
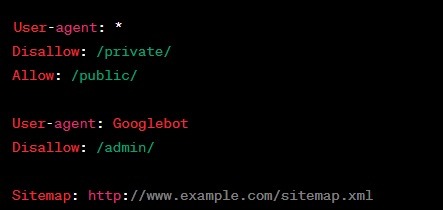
A seguir eu te explico melhor como esse arquivo funciona e como ele atua quando a tarefa é bloquear o rastreamento de crawlers de IA.
O arquivo funciona como um conjunto de instruções para rastreadores de mecanismos de busca, IA, etc. Antes de acessar uma página, robôs que respeitam o protocolo consultam o robots.txt para verificar se há restrições para aquele user-agent.
Em um vídeo do Google Search Central, Gary Illyes e Cherry Prommawin explicam o que de fato você pode acrescentar no robots e como esse arquivo deve ser feito:
Os elementos mais comuns são:
É importante lembrar que o robots.txt não é uma ferramenta de segurança nem um mecanismo de desindexação. Ele solicita que crawlers compatíveis não acessem determinados caminhos, mas não garante o cumprimento por todos os bots.
O robots.txt segue o Robots Exclusion Protocol, padronizado pela RFC 9309. O documento define a linguagem das regras, o tratamento de erros e as instruções de cache para o protocolo.
Se uma diretiva for escrita de forma inválida, o comportamento esperado é que o rastreador ignore a linha e siga a leitura do arquivo. Isso significa que uma regra mal formulada pode não gerar erro visível, mas também não protegerá o conteúdo.
Por exemplo, uma instrução como “don’t crawl secret page” não é uma diretiva reconhecida pelo protocolo. Um crawler compatível descartaria a linha e poderia rastrear a página que o proprietário pretendia bloquear.
O mesmo vale para emojis no campo user-agent. O token de user-agent deve seguir o formato esperado pelo protocolo, com letras e hífens; emojis e outros caracteres multibyte não funcionam nesse campo.
Em caminhos de URL, caracteres especiais, acentos e emojis podem existir, mas a recomendação é usar percent encoding – uma forma de representar esses caracteres usando % seguido de dois dígitos hexadecimais. Por exemplo:
O robots.txt funciona de forma prospectiva: ele orienta crawlers compatíveis a não acessarem determinadas páginas a partir do momento em que a regra entra em vigor. Se você bloquear um rastreador de IA antes de ele rastrear seu site, ele não deverá solicitar essas URLs – e, portanto, não obterá o conteúdo por meio daquele acesso.
Porém, o bloqueio não é retroativo. Se a IA já tiver rastreado a página antes de você adicionar a regra, o robots.txt não remove o conteúdo já coletado, não apaga cópias internas nem garante que aqueles dados sejam excluídos de um treinamento anterior.
Também é importante lembrar que o robots.txt é uma instrução de preferência, não uma barreira técnica. Um rastreador que ignore o arquivo, altere seu user-agent ou acesse o conteúdo por outras fontes, pode continuar coletando informações mesmo com a regra ativa.
Por isso, o robots.txt ajuda a limitar o rastreamento futuro, mas não controla o que uma IA faz com conteúdos já obtidos.
___
E aí, você já sabia disso? Continue acompanhando nossos perfis no Linkedin, YouTube e nossa newsletter para ficar por dentro de todas as novidades do universo do SEO, IA e do Google.

Jornalista e criadora de conteúdo digital, atua há mais de 8 anos desenvolvendo estratégias e textos otimizados para blogs, sites e redes sociais.
Comentários