Os crawlers de IA são uma subclasse de agentes de rastreamento, especializada em fornecer dados a sistemas de Inteligência Artificial, como ChatGPT, Gemini e Claude.
Sendo assim, cabe ao SEO técnico otimizar sites para os crawlers de IA, assim como já faz para os rastreadores dos mecanismos de busca tradicionais. Do contrário, a marca deixa de ser mencionadas e as páginas do site não são citadas nas respostas.
A maior parte das otimizações tradicionais de SEO também se aplica aos crawlers de IA, embora eles tenham as suas especificidades.
O que é um crawler de IA e como ele se enquadra no ecossistema de rastreamento da web moderna?
Os crawlers de IA têm a mesma infraestrutura básica de um rastreador de busca tradicional, como o Googlebot. Ambos descobrem páginas, acessam sitemaps, fazem requisições HTTP, organizam URLs em filas de prioridade (URL frontier) e extraem seu conteúdo.
As principais diferenças estão em seus propósitos operacionais e em seus padrões de consumo de dados.
Os crawlers de IA dividem-se em:
Raspagem para treinamento de modelos: coleta massiva de dados textuais para compor o corpus usado no treinamento de modelos de linguagem. A raspagem é assíncrona e prioriza volume e abrangência, o que gera elevado consumo de banda dos servidores consultados;
Recuperação em tempo real: são coletas pontuais que fundamentam as respostas dos assistentes de IA, via processo de grounding. Costumam ocorrer em resposta a prompts sensíveis ao tempo ou sobre temas de nicho e geram um hyperlink para o conteúdo rastreado. Como o processo ocorre em tempo real, apenas quando necessário para responder ao prompt, as requisições ocorrem em menor volume.
Lista dos principais AI crawlers do mercado
Os crawlers de IA se identificam pelo cabeçalho user-agent, em concordância com as diretrizes RFC 9110 de semântica da web. Veja abaixo a lista dos principais crawlers da atualidade, separados por tipo e categoria.
Clique nos nomes para ler a documentação de cada um.
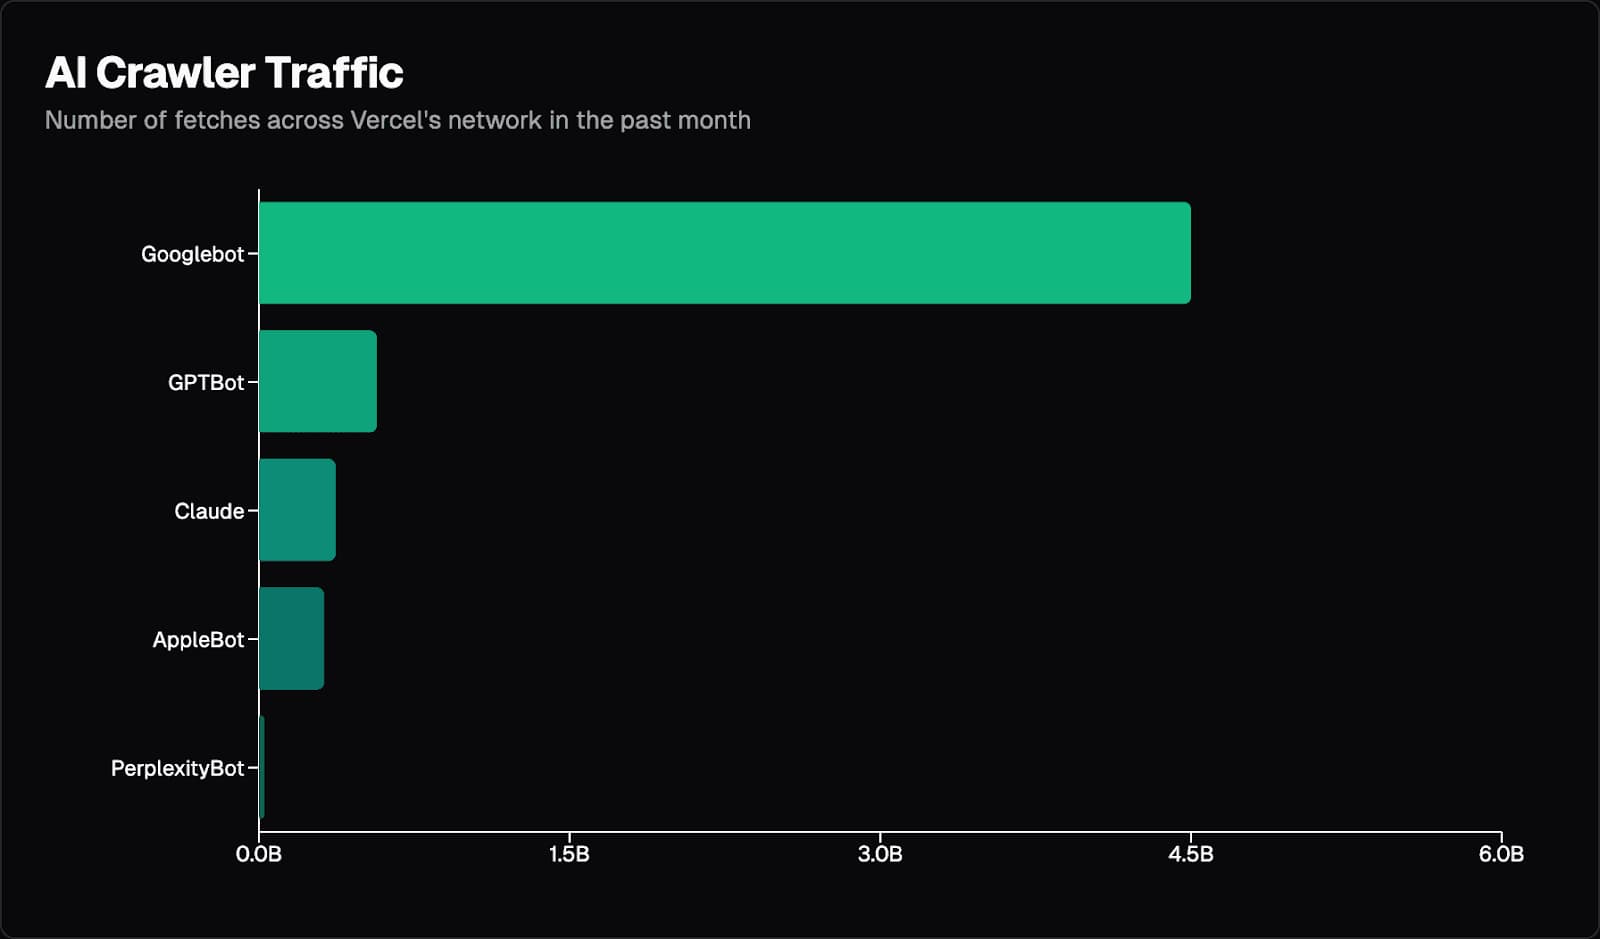
Um estudo publicado pela Vercel no fim de 2024 identificou alguns padrões de comportamento dos crawlers de IA. Os dados referem-se às requisições que eles próprios receberam ao longo do ano, emitidas pelos principais nomes do mercado.
A pesquisa mapeou:
Frequência de rastreamento;
Distribuição geográfica dos agentes;
Formatos de arquivos priorizados;
A (falta de) eficiência no rastreamento;
Uma relação entre rastreamento e tráfego orgânico.
Frequência de rastreamento
Os crawlers de IA fizeram bilhões de requisições às páginas analisadas, com destaque para o Googlebot, disparadamente o mais ativo.
Em novembro de 2024, os números foram:
Googlebot: 4.5 bilhões de requisições (entre produtos Gemini e Pesquisa);
GPTBot: 569 milhões de requisições;
Claude: 370 milhões de requisições;
AppleBot: 314 milhões de requisições;
PerplexityBot: 24.4 milhões de requisições.
Distribuição geográfica dos crawlers
Todos os crawlers de IA acessam as páginas a partir dos Estados Unidos. O ChatGPT sempre de Iowa ou Arizona, e o Claude sempre de Ohio.
Rastreadores de mecanismos de busca tradicionais costumam ficar espalhados. O Googlebot tem IPs em sete estados. E, caso detecte um bloqueio de IP dos EUA, pode tentar acessar a URL através de outros países.
Formatos de conteúdos priorizados no rastreamento
Cada desenvolvedora de IA tem suas preferências próprias sobre os conteúdos que são rastreados.
OpenAI prioriza arquivos HTML;
Anthropic foca mais em imagens;
Google distribui recursos entre HTML, dados JSON, texto puro e JavaScript.
Segundo a Vercel, a preferência por certos tipos de arquivo pode indicar interesses específicos no treinamento de novos modelos de LLM. logo, não é necessariamente uma constante, e sim algo observado durante o período de análise.
A falta de eficiência dos crawlers de IA
Os rastreadores das LLMs gastam muito tempo e recursos em páginas que não existem.
Em números:
34.82% das requisições do ChatGPT são para páginas com status HTTP 404. Outros 14.36% são seguindo redirects;
34.16% das requisições do Claude são para páginas 404;
Para comparação, apenas 8.22% das requisições do Googlebot são para páginas 404 e 1.49% para redirects.
A relação entre rastreamento e tráfego orgânico
Um detalhe interessante sobre a pesquisa é que existe uma correlação entre rastreamento e tráfego orgânico. Quanto mais tráfego, mais requisições a página recebe.
No entanto, este pode ser um comportamento temporário. Dacordo com a pesquisa, as plataformas de IA ainda estão aprendendo quais tipos de URLs devem ser priorizadas.
Escolher páginas populares pode ser apenas um ponto de partida para as novas IAs, o que não é necessário para rastreadores já consolidados, como o Googlebot. Futuramente o cenário pode mudar.
A dinâmica da rastreabilidade: como os crawlers de IA impactam o SEO técnico
Crawlers de IA podem causar prejuízos à infraestrutura dos sites. Os principais problemas estão relacionados ao consumo desordenado de recursos dos servidores, sem que isso se traduza em tráfego direto ou retorno monetário a quem publica conteúdo.
Os principais problemas de SEO técnico causados pelo rastreamento desenfreado por IAs são:
Esgotamento de recursos: o rastreamento descontrolado por crawlers de IA gera picos de requisições simultâneas, que sobrecarregam o servidor. Isso eleva a latência, aumenta o tempo até o primeiro byte (TTFB) e ocasiona erros HTTP 5xx ou 429, o que prejudica a rastreabilidade e, em casos mais severos, tira o site do ar momentaneamente;
Desperdício de recursos: a capacidade de rastreamento de um site é compartilhada entre todos os robôs que o acessam. Se os crawlers de IA sobrecarregarem a infraestrutura, os demais robôs também terão dificuldades para rastrear;
Queda da visibilidade orgânica: O SEO envolve as etapas de rastreamento, renderização, indexação e ranqueamento. Quando crawlers de IA congestionam o servidor, o processo pode ser prejudicado desde o início, causando uma perda gradual de visibilidade orgânica;
Baixo retorno financeiro: o rastreamento dos crawlers de IA não resulta necessariamente em tráfego orgânico significativo. Isso ocorre porque as IAs rastreiam o site, extraem o conteúdo e entregam versões sintetizadas e adaptadas ao prompt do visitante. Um número cada vez menor de pessoas clica nas fontes das informações.
Os sites ainda estão se adaptando a esses possíveis impactos. Para SEO, a estratégia mais eficiente é gerenciar o rastreamentopor meio do arquivo robots.txt, do mesmo modo que se faz com os rastreadores tradicionais. No entanto, alguns sites preferem bloquear completamente os crawlers de IA.
Qual a diferença entre crawlers de IA de pesquisa e treinamento de modelos para o SEO técnico?
As principais diferenças estão na finalidade da coleta de dados e no retorno em termos de tráfego e visibilidade orgânica.
Crawlers de pesquisa, como OAI-SearchBot e Claude-SearchBot, apoiam os recursos de “pesquisar na web” dos assistentes de IA. Portanto, podem gerar citações de marca e tráfego orgânico (embora em volume muito menor do que o SEO tradicional).
Em contrapartida, os crawlers de treinamento de modelos, como CCBot e Bytespider, fazem raspagens massivas para compor bases de dados offline. Por isso, não há retorno direto facilmente mensurável pelas empresas. Quando uma marca ganha representatividade nessa base de dados, ela pode se tornar mais visível nas respostas. Esse impacto é indireto e difícil de medir e atribuir ao SEO, pois também envolve o branding e todo o rastro digital da marca.
Veja abaixo uma tabela que compara detalhadamente os dois tipos de crawlers de IA:
Atributo Arquitetural
Crawlers de pesquisa
Crawlers de treinamento
Exemplos de Agentes
OAI-SearchBot, Claude-SearchBot, ChatGPT-User
GPTBot, ClaudeBot, CCBot, Bytespider
Modo de Execução
Síncrono ou sob demanda do usuário.
Assíncrono em lote profundo.
Retorno para o Site
Positivo, gera atribuição de link, citação e tráfego.
Neutro, pois há consumo de recursos sem tráfego direto imediato.
Impacto na Infraestrutura
Focado e pontual em páginas específicas.
Massivo, podendo saturar conexões se desgovernado.
Recomendação de SEO
Permitir e monitorar, pois garante presença em buscas por IA.
Bloquear ou limitar para proteger o crawl budget do Googlebot.
Crawlers de IA e a renderização de JavaScript
Crawlers de IA ainda não sabem renderizar JavaScript. Logo, se os conteúdos do seu site dependem de códigos JS para renderização, eles estão efetivamente “invisíveis” para as principais LLMs do mercado.
A Vercel descobriu que apenas Google e Apple renderizam JS, e usam tecnologias muito parecidas para isso.
Os principais destaques foram:
O Gemini usa a infraestrutura robusta do Googlebot para renderizar totalmente as páginas;
O AppleBot percorre um caminho similar ao Googlebot para renderizar páginas. Ele pode processar JS, CSS, Ajax e demais recursos;
ChatGPT e Claude conseguem reconhecer arquivos JS, mas não executá-los. Ou seja, não renderizam.
De um ponto de vista de SEO técnico, usar renderização do lado do cliente aumenta as chances de perder espaço nas LLMs. Possivelmente, no futuro todas consigam processar o JS corretamente. Mas, até lá, é melhor entregar o conteúdo da página via HTML.
O dilema ético dos crawlers de IA
Com a ascensão da IA generativa, publishers, criadores de conteúdo e donos de sites passaram a questionar a abordagem de rastreamento das big techs. Há um sentimento de que “a IA rouba conteúdo” sem oferecer qualquer contrapartida a quem o produz.
As críticas são de três ordens:
Técnica, devido ao excesso de requisições enviadas;
De direitos autorais, já que o rastreamento seria uma espécie de “relação parasitária” que prejudica aqueles que publicam informações originais;
Ética, pois as big techs estariam burlando o protocolo de exclusão de robôs (RFC9309) para rastrear sem a permissão dos proprietários dos sites.
Já em outubro de 2026, o mercado de SEO obteve mais detalhes sobre um programa piloto de remuneração do Google, que prevê pagamentos pelo uso de conteúdo em respostas geradas por IA.
Algumas empresas, geralmente as maiores e já bem estabelecidas, adotaram uma solução mais direta: bloquear os crawlers de IA por completo. Estes são três casos notórios:
Diagnóstico e identificação de tráfego com monitoramento de agentes via arquivos de log
Antes de decidir como lidar com os rastreadores de IA, é necessário entender quais estão acessando o seu site, o quanto estão consumindo e se as requisições são legítimas. O modo mais confiável de fazer isso é analisar os logs de acesso do servidor, que registram o volume, a frequência e os padrões das requisições.
Primeiro, você deve encontrar o arquivo de log, que varia de acordo com o software que executa o servidor. Os mais comuns são:
Nginx: /var/log/nginx/access.log
Apache: /var/log/apache2/access.log
IIS: C:\inetpub\logs\LogFiles
Com o arquivo em mãos, você deve filtrar pelo nome dos robôs de IA, como GPTBot, ClaudeBot e CCBot, entre outros. No Nginx e no Apache, o comando é grep -i “GPTBot” /var/log/nginx/access.log | wc -l.
Essa análise de logs permite identificar a carga de rastreamento de IA e padrões anômalos, como requisições paralelas em URLs profundas e armadilhas de rastreamento.
Manning et al. (2009) descrevem as armadilhas de rastreamento como “páginas que induzem os rastreadores a ficarem presos buscando um número infinito de páginas em um determinado domínio”.
Exemplos são URLs de buscas internas e filtros de navegação facetada, que podem gerar milhares (ou até milhões) de URLs. Se os crawlers de IA ficarem presos nelas, haverá desperdício de crawl budget e prejuízos à rastreabilidade do site.
Como verificar se uma requisição assinada por um AI Crawler é autêntica?
O User-Agent que identifica as requisições é informado pelos desenvolvedores do crawler de IA. Esse cabeçalho pode ser facilmente modificado por scrapers não autorizados, no processo chamado de spoofing.
Para validar a autenticidade, é necessário executar o processo de FCrDNS (Forward-Confirmed Reverse DNS), em quatro passos:
Extraia o IP de origem: identifique o endereço IP registrado na requisição nos logs de acesso do servidor (ex.: campo $remote_addr no Nginx ou %h no Apache);
Execute uma busca de DNS Reverso: faça uma consulta PTR no IP de origem utilizando os comandos host <IP> ou dig -x <IP> para obter o nome de domínio associado;
Verifique o domínio de autoridade: confirme se o nome de domínio retornado pertence à organização declarada (ex.: domínios terminados em .openai.com, .anthropic.com ou .googlebot.com);
Execute um Forward DNS (Validação FCrDNS): faça uma busca DNS direta no nome de domínio obtido (host <nome_de_dominio>) e confirme se o IP retornado corresponde exatamente ao IP original da requisição.
Se os endereços coincidirem, a requisição é autêntica. Caso contrário, trata-se de uma falsificação.
Governança de tráfego e estratégia de SEO técnico: métodos de controle e proteção
O controle de tráfego dos rastreadores de IA acontece em três camadas. O arquivo robots.txt define até onde o crawler pode ir; a borda da rede (WAF e CDN) filtra as requisições; e os códigos HTTP informam quando a capacidade do servidor está no limite.
Protocolo de exclusão de robôs (configuração do robots.txt)
O protocolo de exclusão de robôs (RFC 9309) determina que o rastreador procure, no arquivo /robots.txt, o grupo de regras correspondente ao seu product token, que é o nome declarado no User-Agent (GPTBot, ClaudeBot, OAI-SearchBot etc.).
Se houver regras Allow e Disallow para o seu token, o crawler deverá obedecê-las. Caso não exista um grupo específico para esse token, serão aplicadas as regras gerais, identificadas no arquivo por User-agent: *. Assim, é possível liberar robôs de busca e bloquear robôs de treinamento.
Pressione aqui para ver exemplos de diretivas.
# Busca orgânica
User-agent: Googlebot
Allow: /
# Token de controle: define se o conteúdo rastreado pelo Googlebot
# pode ser usado no Gemini. Não afeta a indexação na Busca.
User-agent: Google-Extended
Allow: /
# Busca e citação sob demanda (RAG)
User-agent: OAI-SearchBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
# Coleta para treinamento
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: CCBot
Disallow: /
User-agent: Bytespider
Disallow: /
Proteção em borda
O arquivo robots.txt depende da cooperação do crawler. Isto é, scrapers maliciosos simplesmente o ignoram. Para combater esse comportamento, sites podem usar tecnologias de WAF (Web Application Firewall, que filtra requisições HTTP por regras) e CDN (rede de servidores distribuídos que entrega o conteúdo a partir de pontos de presença próximos ao visitante).
As principais soluções do mercado, como Cloudflare, Fastly e AWS CloudFront, apresentam mecanismos como:
Bot Score: modelos de aprendizado de máquina analisam o comportamento de cada requisição na rede e atribuem uma pontuação, permitindo aplicar regras específicas a robôs não verificados.
Limitação de requisições: limita o número de requisições, com regras que definem um volume máximo por minuto para cada IP ou para URLs com parâmetros. A própria CDN também pode absorver parte do volume de acessos, evitando sobrecargas;
Desafios de validação: requisições suspeitas são submetidas a um CAPTCHA antes de serem processadas e de consumirem recursos do site.
Tratamento de sobrecargas com códigos de resposta HTTP
Os códigos HTTP comunicam o resultado de uma requisição. Dois deles podem indicar que o servidor está atingindo seu limite de capacidade:
429 (Too Many Requests) indica que o cliente excedeu o limite de requisições permitido no intervalo;
O 503 (Service Unavailable) indica indisponibilidade temporária por sobrecarga ou manutenção.
Se esses códigos forem frequentes, o site poderá deixar de ser rastreado, o que protege o servidor, mas limita sua visibilidade. Os crawlers interpretam os códigos de maneira diferente. O Googlebot, por exemplo, usa ambos para controlar a cota de rastreamento de um site.
Donos de sites podem configurar a resposta HTTP junto de um cabeçalho Retry-After, que informa quando o robô deve tentar novamente.
Quais são os riscos para o SEO ao aplicar bloqueios genéricos a todos os agentes de rastreamento?
Bloqueios genéricos, de uma faixa inteira de IPs no firewall ou com regra Disallow: / para todos os crawlers de IA no robots.txt, expõem o site a dois riscos graves de SEO:
Invisibilidade nos buscadores tradicionais, devido a bloqueios acidentais do Googlebot e de outros rastreadores de busca;
Perda de visibilidade nos assistentes de IA, já que os bloqueios impedem que os mecanismos de IA consultem o site em tempo real para o grounding.
É importante lembrar que, caso seu site não apareça, seus concorrentes poderão ocupar esse espaço.
Quais são as principais ações para otimizar o rastreamento por crawlers de IA?
As principais boas práticas para melhorar a rastreabilidade de um site são:
Usar renderização do lado do servidor (SSR) para conteúdos com potencial para SEO. Incluem-se aqui posts de blog, informações sobre produtos, documentações, meta tags, estruturas de navegação e outros elementos semelhantes. Se esse tipo de informação depender de JS para carregar, a IA não os enxergará;
Aplicar renderização do lado do cliente (CSR) para funções não-críticas, como elementos interativos, widgets, feeds de rede social, além de páginas dinâmicas e aplicações web;
Manter as boas práticas tradicionais de SEO para gerenciamento de URLs. Corrija erros 404, mantenha seus sitemaps atualizados e use estruturas de links consistentes nas suas páginas.
Apresentar informações críticas em HTML. Evite modificar tags usando JS e entregar conteúdos importantes que dependem da renderização para aparecer. Assim você reduz o risco de partes do conteúdo ficarem visíveis para o Google, mas invisíveis para a IA. Seguno Kevin Indig, especialista em SEO, a ausência de preço no HTML é uma das principais barreiras para as IAs;
Evitar arquivos em markdown. Crawlers de IA não aessam versões markdown de páginas do seu site. A prática de criar versões MD de páginas tornou-se bastante difundida, mas, segundo John Mueller, porta-voz do Google, não traz benefícios do ponto de vista de SEO. O arquivo llms.txt também é inútil (apesar do nome, ele também é escrito em formato markdown).
Elyson Gums é redator na SEO Happy Hour. Trabalha com redação e produção de conteúdo para projetos de SEO e inbound marketing desde 2014, em segmentos B2C e B2B. É bacharel em Jornalismo (Univali/SC) e mestre em Comunicação Social (UFPR).





Comentários